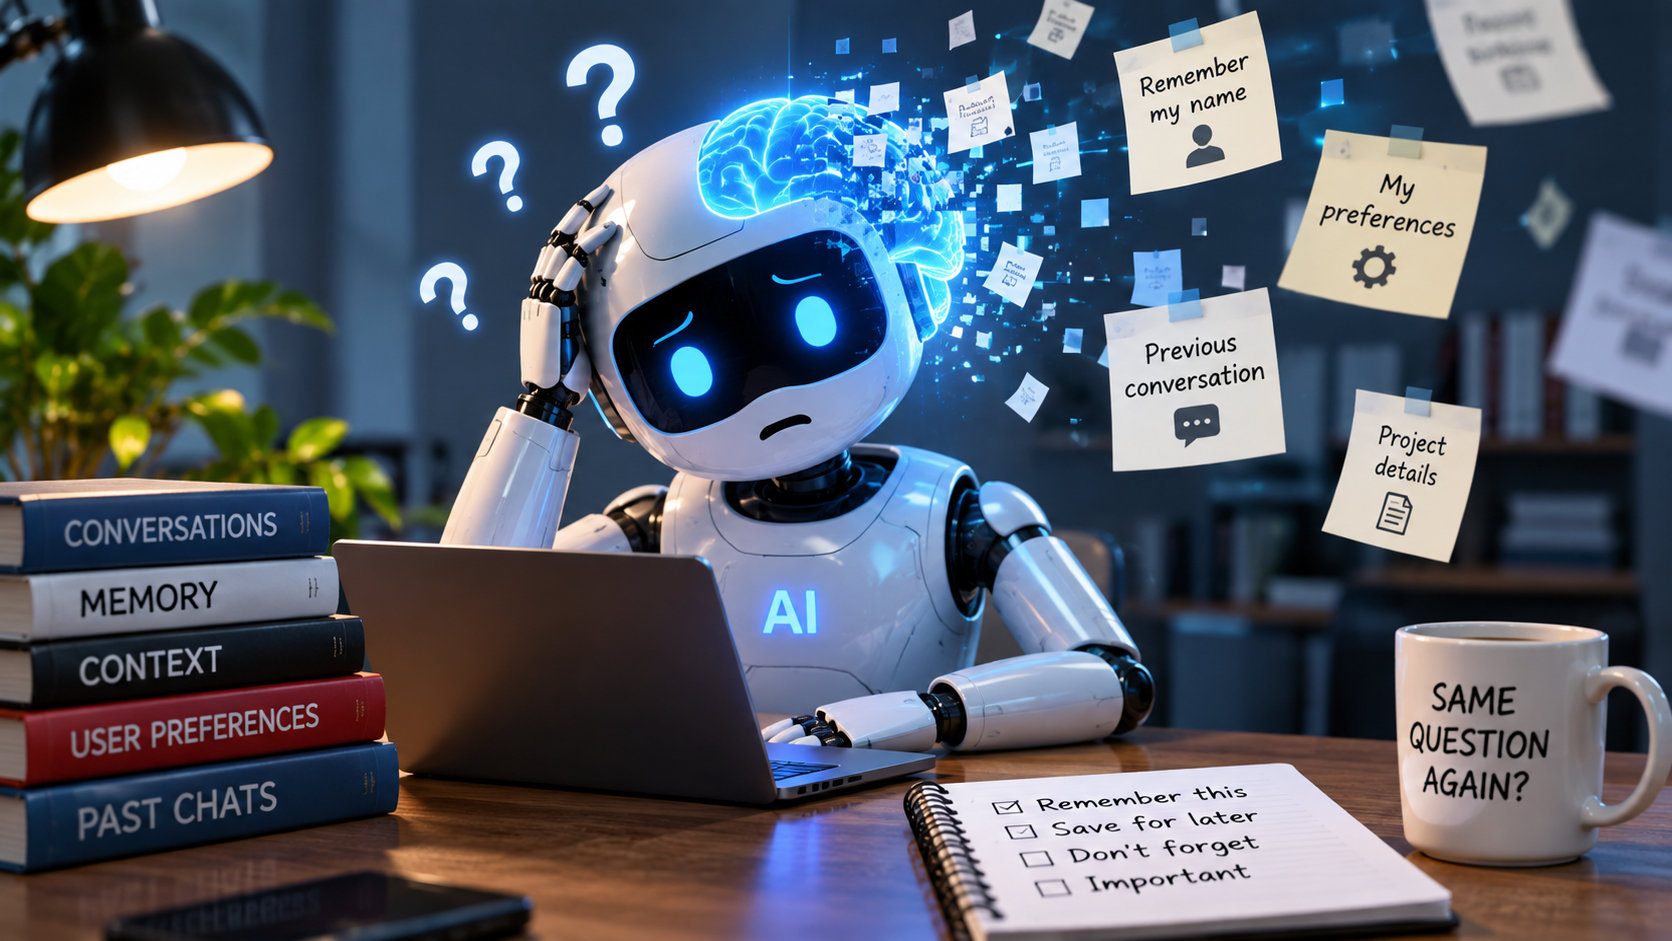
एआई अम्नेशिया (AI amnesia) उस अनुभव का नाम है, जब कोई एआई टूल पहले बताई गई जानकारी, पसंद या निर्देश को बाद की बातचीत में याद नहीं रखता। यह स्थिति इंसानों जैसी याददाश्त खोने का संकेत नहीं है। एआई मॉडल जवाब बनाते समय उसी जानकारी पर निर्भर करता है, जो उस क्षण उसके संदर्भ में उपलब्ध कराई गई हो।
एआई टूल अब सवालों के जवाब देने से आगे बढ़कर लिखने, कोडिंग और लंबे कामों में मदद कर रहे हैं। ऐसे में किसी जरूरी निर्देश का छूट जाना केवल छोटी असुविधा नहीं रह जाता। लंबे प्रोजेक्ट, कारोबारी जानकारी और एजेंट की तरह काम करने वाली प्रणालियों में सही सूचना का सही समय पर इस्तेमाल महत्वपूर्ण हो जाता है।
एआई की context और memory अलग चीजें हैं
किसी बातचीत के दौरान मॉडल को उपलब्ध जानकारी उसका context यानी संदर्भ होती है। इसमें मौजूदा सवाल, पहले के संदेश, निर्देश, दस्तावेज और ऐप की ओर से दी गई अन्य सामग्री शामिल हो सकती है। मॉडल इस जानकारी से जवाब तैयार करता है, लेकिन वह अपने-आप पिछली बातचीत को इंसानी तरीके से याद नहीं करता।
अलग बातचीत में जानकारी ले जाने के लिए ऐप को अतिरिक्त सिस्टम की जरूरत होती है। वह उपयोगकर्ता की पसंद या जरूरी विवरण स्टोर कर सकता है। फिर नई बातचीत शुरू होने पर संबंधित जानकारी खोजकर मॉडल के संदर्भ में जोड़ सकता है। डेटाबेस, सारांश और retrieval tools इसी काम में इस्तेमाल हो सकते हैं।
OpenAI के अनुसार, ChatGPT की memory का उद्देश्य पिछली बातचीत से उपयोगी जानकारी और पसंद को आगे ले जाना है। यह सिस्टम संदर्भ को बनाए रखने, उपयोगकर्ता की प्राथमिकताओं का पालन करने और परिस्थितियां बदलने पर जानकारी अपडेट करने में मदद करता है।
लंबी चैट में जानकारी क्यों छूट जाती है
हर एआई मॉडल एक समय में सीमित मात्रा में जानकारी प्रोसेस कर सकता है। बातचीत लंबी होने पर पुराने संदेश, नए सवाल, दस्तावेज और निर्देश एक ही संदर्भ में जमा होते जाते हैं। लेकिन बड़ी context window होने का यह मतलब नहीं कि मॉडल हर जानकारी को समान रूप से इस्तेमाल करेगा।
Developer Way के प्रयोगों में Claude Sonnet और GPT-5 के साथ देखा गया कि संदर्भ में सामग्री बढ़ने पर मॉडल का प्रदर्शन कम consistent हो सकता है। इस स्थिति को context rot कहा गया है। यह समस्या मॉडल की बताई गई संदर्भ सीमा तक पहुंचने से पहले भी दिखाई दे सकती है।
जब महत्वपूर्ण तथ्य बहुत-सी असंबंधित सामग्री के बीच दब जाता है, तो मॉडल उसे नजरअंदाज कर सकता है या दूसरे विवरणों के साथ मिला सकता है। एक प्रयोग में बड़े संदर्भ के बीच मौजूद जानकारी को चूकने या इनपुट के दूसरे हिस्सों से मिलाने की संभावना अधिक बताई गई।
इसलिए चैटबॉट का किसी पुरानी बात पर सही जवाब न देना हमेशा उस जानकारी के मिट जाने का मतलब नहीं होता। संभव है कि मॉडल ने उसे उस उत्तर के लिए पर्याप्त महत्व नहीं दिया हो।
मॉडल अपडेट से व्यवहार कैसे बदल सकता है
मशीन लर्निंग में catastrophic forgetting एक अलग तकनीकी समस्या है। जब मॉडल को नई जानकारी या नए काम के लिए दोबारा ट्रेन किया जाता है, तो पहले सीखे गए किसी काम की क्षमता कम हो सकती है। नई ट्रेनिंग पुराने कामों से जुड़ी जानकारी में हस्तक्षेप कर सकती है।
यह समस्या कल की बातचीत भूलने से अलग है। बातचीत के मामले में ऐप ने पुरानी जानकारी मॉडल को दी ही नहीं हो सकती, या मॉडल बड़े संदर्भ में सही तथ्य का इस्तेमाल नहीं कर पाया हो सकता है। catastrophic forgetting में बदलाव मॉडल की ट्रेनिंग और उसके internal parameters से जुड़ा होता है।
नए प्रशिक्षण के दौरान मॉडल के weights में बदलाव भी पहले सीखे गए कामों पर असर डाल सकते हैं। IBM के अनुसार, regularisation, rehearsal और architectural approaches जैसी तकनीकों से इस जोखिम को घटाने की कोशिश की जाती है। उपयोगकर्ता को इसका असर कभी-कभी अचानक बदले जवाबों के रूप में दिखाई दे सकता है।
बहुत ज्यादा जानकारी का असर
बड़े language models अलग-अलग सूचनाओं के बीच संबंध पहचानने के लिए बनाए गए हैं। फिर भी, सामग्री बढ़ने पर उनके लिए यह तय करना कठिन हो सकता है कि सबसे महत्वपूर्ण क्या है। बड़े संदर्भ में काम करते समय मॉडल जानकारी छोड़ सकते हैं, दस्तावेजों के विवरण मिला सकते हैं या असंगत सारांश बना सकते हैं।
यह चुनौती उन एआई एजेंटों के लिए खास है, जिन्हें ईमेल, दस्तावेज, डेटाबेस और पुरानी बातचीत के साथ काम करना होता है। ऐसे सिस्टम के लिए केवल सारी जानकारी स्टोर करना पर्याप्त नहीं है। उन्हें जरूरत के समय सही जानकारी खोजकर मॉडल तक पहुंचानी भी होती है।
क्या एआई से जानकारी जानबूझकर हटाई जा सकती है
मशीन अनलर्निंग (machine unlearning) में यह जांच की जाती है कि किसी प्रशिक्षित मॉडल से खास जानकारी कैसे हटाई जाए, बिना पूरे सिस्टम को फिर से ट्रेन किए। इसका संबंध privacy, copyright और पुरानी हो चुकी जानकारी जैसे मुद्दों से हो सकता है।
Ensolvers ने selective amnesia को ऐसी पद्धति के रूप में बताया है, जिसमें एआई मॉडल से चुनिंदा जानकारी हटाने की कोशिश की जाती है। इसमें Harry Potter की किताबों से संबंधित जानकारी को हटाने और मॉडल की व्यापक क्षमताएं बनाए रखने की कोशिश वाले शोध का उल्लेख है।
लेकिन प्रशिक्षित मॉडल से जानकारी हटाना कंप्यूटर की किसी फाइल को delete करने जैसा आसान नहीं है। मॉडल में ज्ञान उसके parameters के भीतर patterns और relationships के रूप में मौजूद होता है। एक तथ्य हटाने की कोशिश दूसरी क्षमताओं को भी प्रभावित कर सकती है।
एक और मुश्किल यह साबित करना है कि मॉडल ने सचमुच जानकारी भूल दी है। कभी-कभी carefully designed prompts के जरिए ऐसी जानकारी फिर सामने आ सकती है, जिसे हटाया हुआ माना गया था।
एआई मेमोरी का अगला सवाल
एआई सिस्टम के सामने बड़ी चुनौती केवल याद रखने की नहीं है। उन्हें यह भी तय करना होगा कि कौन-सी जानकारी उपयोगी है, उसे कब वापस लाना है, बदलती परिस्थितियों में उसे कैसे अपडेट करना है और पुरानी सूचना को नई सूचना से कैसे अलग रखना है।
यही वजह है कि context, ऐप की memory और मॉडल की training को एक ही समस्या समझना सही नहीं है। उपयोगकर्ता को दिखने वाला “भूलना” इन तीनों में से किसी एक स्तर पर retrieval, processing या learned behaviour की समस्या हो सकता है।
निष्कर्ष
एआई अम्नेशिया किसी एक तरह की भूल नहीं है। लंबी बातचीत में संदर्भ का दबाव, ऐप की memory व्यवस्था, retrieval की कमी, मॉडल अपडेट और नई ट्रेनिंग इसके अलग-अलग कारण हो सकते हैं।
अक्सर पूछे जाने वाले सवाल
Q. एआई अम्नेशिया क्या है?
यह उस स्थिति का सामान्य नाम है, जब एआई पहले दी गई जानकारी, पसंद या निर्देश को बाद में याद नहीं रखता या उसका इस्तेमाल नहीं करता।
Q. क्या एआई इंसानों की तरह भूलता है?
नहीं। एआई मॉडल जवाब बनाते समय उपलब्ध context और ऐप से मिली अतिरिक्त जानकारी पर निर्भर करता है।
Q. लंबी बातचीत में एआई जरूरी बात क्यों छोड़ सकता है?
बहुत-सी सामग्री के बीच जरूरी जानकारी का महत्व कम हो सकता है। मॉडल उसे नजरअंदाज कर सकता है या दूसरे विवरणों से मिला सकता है।
Q. context और memory में क्या अंतर है?
Context वह जानकारी है जो किसी खास interaction के समय मॉडल को उपलब्ध होती है। Memory वह जानकारी है जिसे ऐप भविष्य की बातचीत के लिए स्टोर या retrieve करता है।
Q. catastrophic forgetting क्या है?
यह नई ट्रेनिंग या fine-tuning के बाद पहले सीखे गए किसी काम की क्षमता कम होने की तकनीकी समस्या है।
Q. क्या मॉडल अपडेट से एआई का जवाब बदल सकता है?
हां। मॉडल की training या weights में बदलाव से वह पहले संभाली गई जानकारी या काम पर अलग तरह से प्रतिक्रिया दे सकता है।
Q. machine unlearning का उद्देश्य क्या है?
इसका उद्देश्य किसी प्रशिक्षित मॉडल से खास जानकारी हटाने की संभावना तलाशना है, बिना पूरे सिस्टम को दोबारा train किए।
Q. एआई से जानकारी हटाना मुश्किल क्यों है?
मॉडल में ज्ञान फाइल की तरह अलग जगह नहीं रखा होता। वह parameters में patterns और relationships के रूप में मौजूद रहता है।
Q. क्या हटाई गई जानकारी फिर सामने आ सकती है?
कभी-कभी carefully designed prompts के जरिए ऐसी जानकारी वापस सामने आने की संभावना बताई गई है।