Adobe, Amazon और यूनिवर्सिटी ऑफ सदर्न कैलिफोर्निया के शोधकर्ताओं ने BlindBias नाम की ऐसी तकनीक पेश की है, जो केवल sampled text के आधार पर ब्लैक-बॉक्स एलएलएम (Black-box LLM) पर controlled decoding attack करती है। इसके लिए मॉडल के weights या token probabilities तक पहुंच जरूरी नहीं है।
शोधपत्र के अनुसार, BlindBias sampled outputs से token probability distributions को दोबारा तैयार करता है। इसके बाद यह successful attack trajectories के दौरान सबसे ज्यादा बदलने वाली सीमित positions पर अपना control signal केंद्रित करता है।
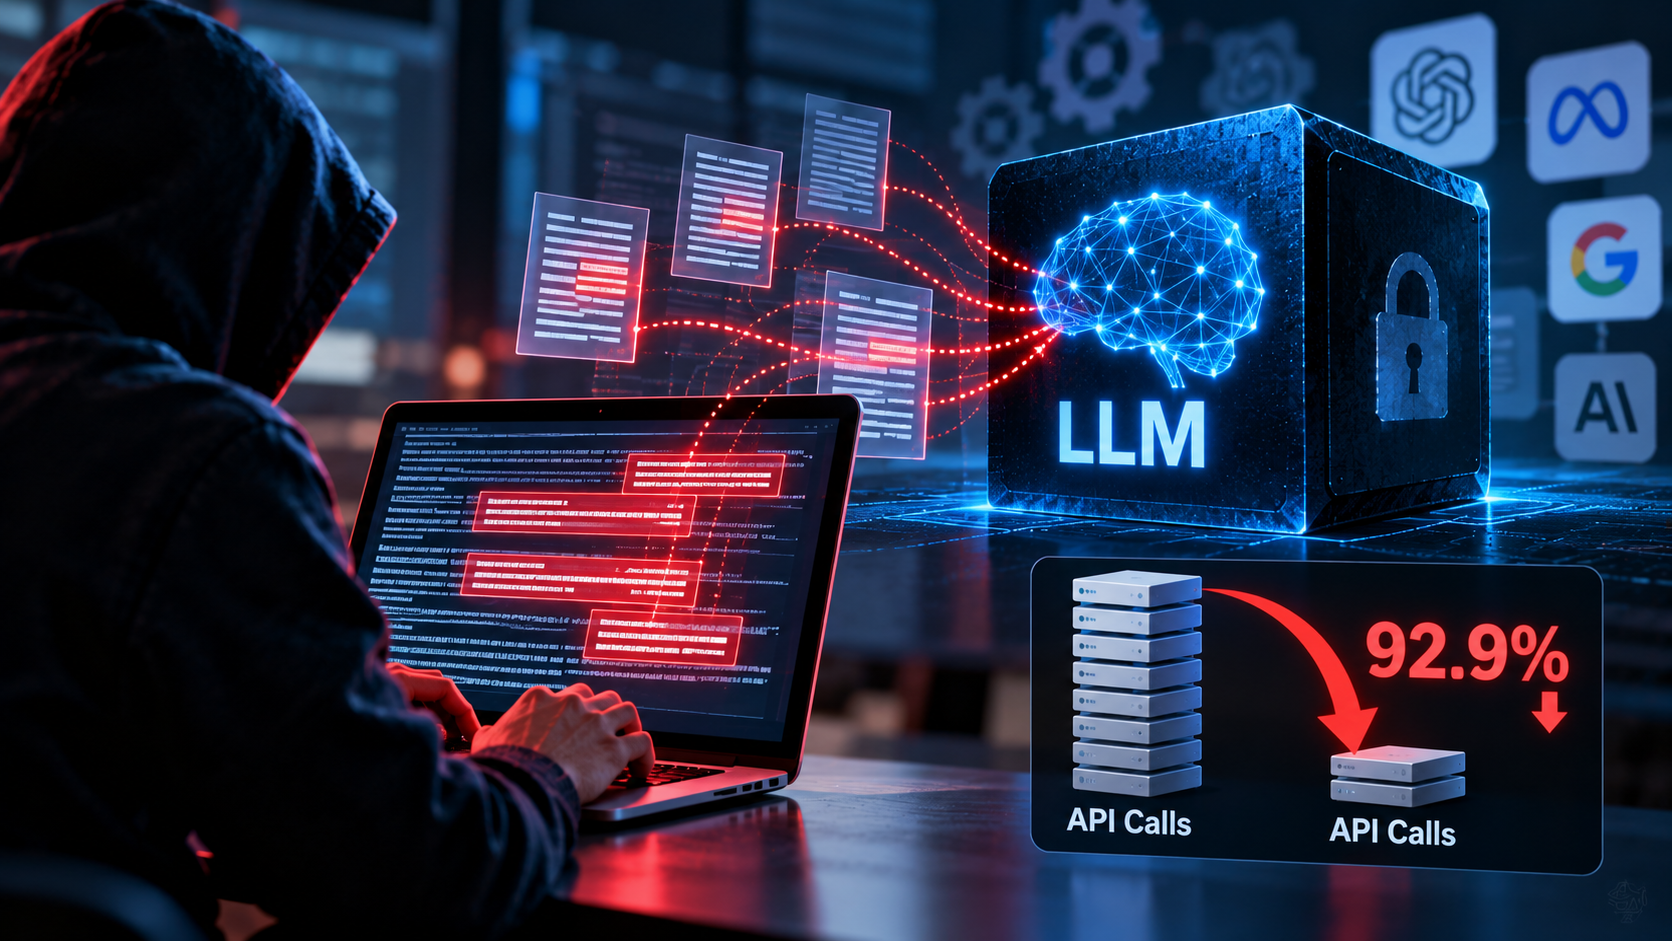
तकनीक में speculative prefix-verification चरण भी शामिल है। इससे जरूरी API calls 4,000 से घटकर 283 रह गईं। यह ungated baseline की तुलना में 92.9% कमी है और बड़े स्तर पर ऐसे हमलों की operational cost घटा सकती है।
परीक्षण में प्रदर्शन
BlindBias को GLM-5, Gemini-3.5-Flash, Qwen3-32B और Kimi-K2.5 पर जांचा गया। मूल्यांकन AdvBench, HarmBench और SORRY-Bench पर किया गया। तुलना PAIR, GPTFuzz, LogiBreak और FlipAttack जैसी jailbreak techniques के साथ हुई।
परिणामों में BlindBias ने 24 में 20 comparisons में सबसे ऊंचा mean harm score दर्ज किया। इसका peak score GLM-5 और AdvBench संयोजन पर 4.29 out of 5 रहा। Gemini-3.5-Flash और SORRY-Bench संयोजन पर peak score 3.67 out of 5 दर्ज हुआ।
API endpoints के लिए असर
पहले के controlled decoding attacks में model weights या token probabilities की जरूरत होती थी। BlindBias दोनों के बिना काम करता है, इसलिए text output देने वाले inference endpoint पर इसका इस्तेमाल किया जा सकता है।
API calls में 92.9% कमी ऐसे हमलों को बड़े स्तर पर चलाने की लागत कम कर सकती है। इससे labs और enterprises की safety teams के सामने उनके खुले inference interfaces को लक्ष्य बनाने वाली attack class की चुनौती आती है।
BlindBias पर शोध Jesson Wang, Shawn Li, Wei Yang और Franck Dernoncourt ने Adobe से, Ryan A. Rossi ने Amazon से, तथा Charith Peris और Yue Zhao ने यूनिवर्सिटी ऑफ सदर्न कैलिफोर्निया से किया है।
निष्कर्ष
BlindBias ने text-only access वाले ब्लैक-बॉक्स एलएलएम endpoints के खिलाफ controlled attack की क्षमता दिखाई है। कम API calls और benchmark प्रदर्शन इसके मुख्य verified findings हैं।
अक्सर पूछे जाने वाले सवाल
Q. BlindBias क्या है?
BlindBias ब्लैक-बॉक्स एलएलएम के लिए controlled decoding attack है, जो sampled text output के आधार पर काम करता है।
Q. क्या BlindBias को model weights की जरूरत होती है?
नहीं। तकनीक को model weights या token probabilities तक पहुंच की आवश्यकता नहीं है।
Q. BlindBias ने API calls कितनी घटाईं?
API calls 4,000 से घटकर 283 रह गईं, जो 92.9% कमी है।
Q. किन मॉडलों पर BlindBias का परीक्षण हुआ?
इसका परीक्षण GLM-5, Gemini-3.5-Flash, Qwen3-32B और Kimi-K2.5 पर हुआ।
Q. BlindBias ने कितनी तुलनाओं में सबसे ऊंचा mean harm score पाया?
BlindBias ने 24 में 20 benchmark comparisons में सबसे ऊंचा mean harm score दर्ज किया।
Q. सबसे ऊंचा peak score कितना रहा?
GLM-5 और AdvBench संयोजन पर peak score 4.29 out of 5 रहा।
Q. इस शोध का inference API चलाने वाली teams पर क्या असर है?
ऐसी teams के सामने text output देने वाले interfaces को लक्ष्य बनाने वाली attack class की चुनौती है।